Tokens, Skill ? oui oui, parce que je me dis que partager mon apprentissage, peut vous donner des idées pour votre entreprise ◡̈
Une skill (pour ceux qui ne savent pas), c’est un mode d’emploi que l’on donne une fois à Claude et qu’il réutilise ensuite.
Celle, dont je vais vous parler, me sert à préparer mes rendez-vous clients : questions à poser, points à vérifier, format du compte rendu, etc. Au fil des semaines, j’ai ajouté une règle ici, une exception là.
Dernièrement, je l’ai rouverte pour retirer une consigne que je ne voulais plus. Impossible de la retrouver sans tout relire.
Chercher une phrase dans un pavé, C’est le genre de choses qui 𖡎 m’agace parce que ça me fait perdre du temps. Je me suis dit qu’il fallait faire du ménage dans tout ça.
J’avais bien entendu dire de limiter les tokens d’une skill. Mais je n’en savais pas vraiment plus que ça… (vous si ?)
Sommaire
Alors, un token, c’est quoi ?
Un token, c’est l’unité de texte que Claude lit.
Ce n’est ni une lettre ni un mot ꙭ, mais un morceau de mot.
Un mot courant comme « le » fait un seul token. Un mot long ou rare peut être coupé en plusieurs morceaux. La ponctuation compte aussi.
Pour vous le montrer, j’ai utilisé l’outil Tokenizer d’OpenAI, qui découpe un texte et colore chaque token.
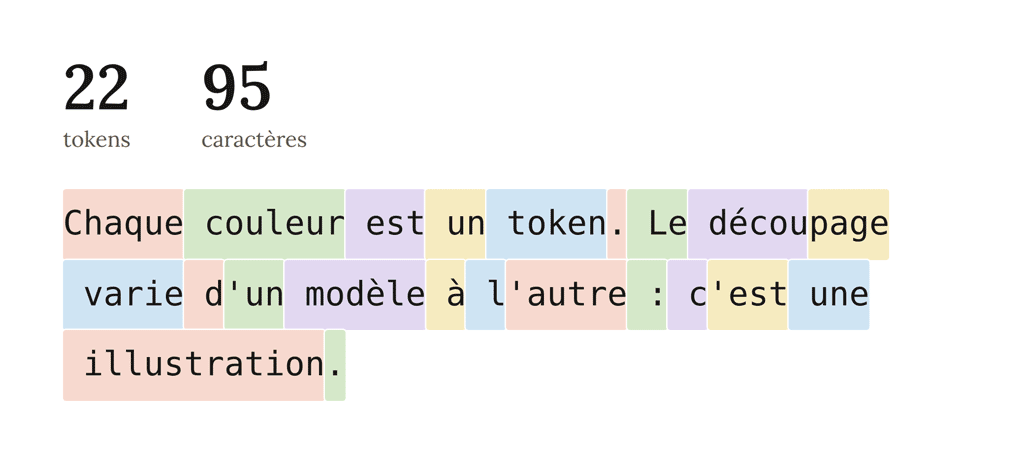
Cette phrase fait 95 caractères et 22 tokens, soit environ 4 caractères – 4,3 si on veut être très précis – par token pour ChatGPT.
Le découpage varie d’un modèle à l’autre : celui de Claude n’est pas exactement le même que celui de ChatGPT. Je précise cela, parce que j’utilise Claude actuellement, mais tout ce que je vous explique sur les skills (compétences) fonctionne aussi pour celles de ChatGPT.
Vous voulez vous rendre compte des différences de comptages selon les IA ? Allez donc faire un tour sur ce site : claudetokenizer.com
Revenons à mon Claude, tout ce qu’il lit se compte en tokens : ma skill, mes messages, les fichiers que je lui donne.
Pourquoi limiter les tokens, et comment les mesurer ?
Deux raisons de surveiller la taille d’une skill :
- Votre quota. Tout ce que Claude lit consomme votre quota d’utilisation, et une skill est relue à chaque fois qu’elle sert.
- La « mémoire de travail », c’est-à-dire le texte qu’il peut garder en tête pendant une session. Plus la skill est longue, moins il reste de place pour le reste, et plus les règles importantes risquent d’être noyées.
Compter les caractères de votre skill
Après un petit découpage, comme je vous l’explique après, ma skill est passée de 180 à environ 140 lignes.
Mais ce chiffre, on est d’accord, ne dit pas grand-chose, parce qu’une ligne peut faire 3 mots comme 80. C’est pourquoi il vaut mieux compter les caractères.
Pour ça, le plus simple reste encore de demander à Claude : « Compte les caractères de cette skill, espaces et ponctuation compris, avec ton outil de code ».
Si le résultat vous semble douteux, collez votre texte dans Word, ou tout outil qui affiche le nombre de caractères (espaces compris).
Ma skill, elle, fait environ 14 000 caractères.
Pour compter plus précisément
- Pour ChatGPT, l’outil Tokenizer d’OpenAI, gratuit en ligne, donne le compte de ses modèles. Il sous-estime ce que compte Claude, qui découpe le texte plus finement (étude publiée en 2026).
- Pour Claude, Anthropic propose un outil de comptage officiel, mais il est réservé aux développeurs.
Ma recommandation : le découpage en trois niveaux
Compter, c’est bien. Encore faut-il savoir quelle limite ⁀➴ viser.
Voici un ordre de grandeur en tokens pour chacune de ses trois parties :
- Le nom & la description : environ 100 tokens. Toujours chargés, pour toutes vos skills.
- Les instructions (le texte principal de la skill) : moins de 5 000 tokens recommandés (spécification des skills). Elles ne sont chargées que lorsque la skill sert.
- Les fichiers annexes (modèles, références) : pas de limite pratique, puisqu’ils ne sont lus qu’au besoin.
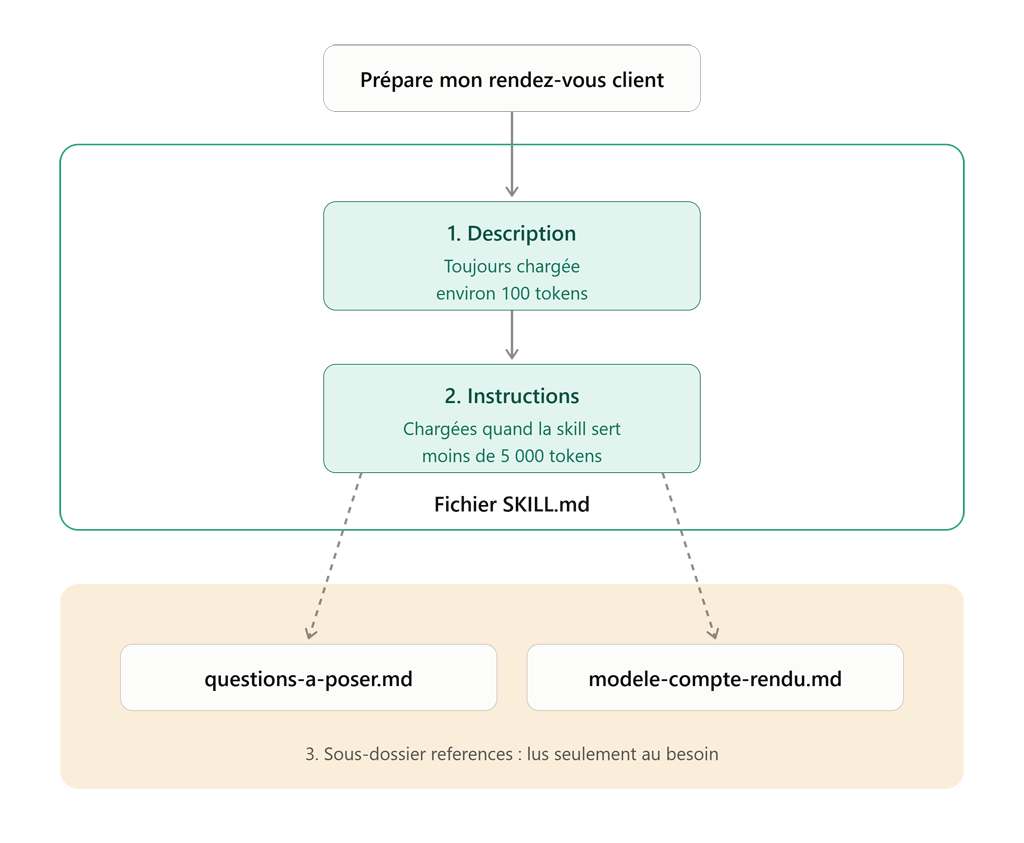
Ce découpage en trois niveaux repose sur un principe appelé la « divulgation progressive ».
L’idée : Claude ne lit pas tout d’un coup. Il commence par le plus léger (le nom et la description) → puis charge les instructions quand la skill sert → et enfin les fichiers annexes seulement si la tâche en a besoin.
Une skill bien construite suit cette logique : l’essentiel dans le fichier principal, le détail dans des fichiers à part.
La méthode simple pour rester sous 5 000 tokens
- Comptez les caractères de votre skill.
- Avec Claude, visez 10 000 caractères au maximum, espaces et ponctuation compris. Avec lui, on n’a pas de moyen simple de savoir combien de tokens il compte vraiment : c’est donc une (grosse) marge de sécurité. Mieux vaut viser large.
- Supprimez les doublons et les règles qui se contredisent. Une skill un peu plus longue mais cohérente vaut mieux qu’une courte qui se contredit.
- Si vous dépassez, déplacez ce qui ne sert pas à chaque fois (modèles, exemples, listes longues) dans des fichiers à part, que Claude ne lit qu’au besoin.
- Recomptez.
Ma skill est au-dessus de cette marge. Pourtant, j’ai déjà sorti le modèle de compte rendu et les listes de questions dans des fichiers à part, pour la rendre plus légère.
Il faut donc à présent que je regarde ce qui est superflu, ou ce que je peux retirer d’autre. Oui, il le faut (。- .•)
Retenez que tout ceci n’est qu’une règle pratique, pas une mesure exacte. Cela pourra évoluer avec le temps : je vous donne simplement les informations que j’ai aujourd’hui pour vous aider.
Et si quelqu’un a de l’eau à apporter à mon seau, welcome ✺◟(•‿•)◞✺ dans les commentaires !
Conclusion
- Un token est un morceau de mot, et tout ce que Claude lit se compte ainsi.
- On fait attention à ses tokens.
- Ce qui ne sert pas à chaque fois va dans des fichiers à part : la skill est plus légère, on s’y retrouve plus facilement et l’IA aussi.
Au départ, je voulais simplement ne plus chercher une phrase dans un pavé. Les tokens m’ont donné une raison de plus de faire le ménage.
À vos balais !
Cet article vous a aidé ? Vous souhaitez une ressource complémentaire ? Dites-le moi en commentaire, ça me fait super plaisir de vous lire ♡ …et de savoir que le billet vous a été utile !


0 réponse